从 NeRF 到可变形 3DGS
读懂张波涛论文的
技术前史

十二篇论文,一条主线:三维场景怎样被表示、怎样被改动。
目标是把《基于高斯泼溅的辐射场变形方法研究》的每一项创新,都还原到它继承自哪里、真正新增了什么。

文献方向辐射场变形与可编辑 3DGS
目标材料张波涛硕士论文(2025)
篇数12 篇前作 + 1 篇目标论文
汇报日期2026-09-15
导

这份报告想解决什么

不是逐篇摘要,而是建一条能自己往下走的路
导读

一个常见的困境

直接翻张波涛论文,会看到「球谐特征系数」「身份标识编码」「变形 MLP」「半径滤波」—— 每个词都认识,但连不起来。因为这些词不是他发明的,而是从过去五年十几篇论文里一层层搭上来的。不读前作,读不懂论文;但一篇篇硬啃,又看不到重点。

这份报告的组织方式

  • 按「读完前一篇,才看得懂后一篇为什么成立」排序,而不是按年份
  • 每篇只回答三个问题:它解决什么痛点、关键招数是什么、和目标论文什么关系
  • 公式只保留能讲清物理意义的那一两个,不推推导
  • 每读完一个阶段,回到张论文对应那一章,做一次继承 / 新增的对照

读完你应该能回答

  • NeRF 和 3DGS 的表示、渲染、训练机制差在哪?
  • 为什么「动态重建」「可编辑变形」「对象移除」是三件不同的事?
  • 张论文三章分别继承了谁,真正新增了什么?
  • 哪些问题在汇报时最可能被追问?
阅读提示:带 虚线下划线 的是术语,鼠标悬停有解释。
01

先把问题拆开:辐射场里其实是三类问题

不分清这三类,后面十几篇论文会混成一团
总览

① 重建

从一堆照片恢复出可渲染的三维场景。

关键词:表示、渲染、初始化、致密化
→ 对应 NeRF、3DGS、GaussianPro、Revising Densification

② 编辑

在已建好的场景里,认出某个物体、把它单独选中、删掉或改掉。

关键词:分割、身份编码、分组、空洞修补
→ 对应 SPIn-NeRF、Gaussian Grouping

③ 变形

让场景随时间运动,或按用户意图被拉伸、弯曲、移动。

关键词:规范空间、变形场、时间编码、控制点
→ 对应 D-NeRF、Nerfies、Deformable 3D Gaussians、4D-GS、SC-GS、GaussianMesh

关键认识:张波涛论文的标题是「辐射场变形方法研究」,但它三章分别落在重建(第 3 章改初始化点云)、编辑(第 4 章对象分组与移除)、变形(第 5 章动态重建)三个不同的问题上。 它不是沿一条技术线推进,所以必须分别找最近的前作来做对照,不能笼统地比。
02

一张图看懂整条脉络

下面每个点都是一篇论文;颜色表示它属于哪一类问题
总览
2020
NeRF
隐式辐射场
起点
2021
D-NeRF
规范空间
+ 时间形变
2021
Nerfies
变形场
正则化
2023
SPIn-NeRF
NeRF 上
删物体
2023
3DGS
显式高斯
实时渲染
2024
GaussianPro
逐步传播
补点
2024
Revising
Densification
用误差
替代梯度
2024
Gaussian
Grouping
身份编码
与分组
2024
Deformable
3D Gaussians
规范高斯
+ 变形场
2024
4D-GS
时空平面
编码
2024
SC-GS
稀疏
控制点
2024
GaussianMesh
网格驱动
大变形
2025
张波涛论文
三章分别
继承上图三支
● 表示与地基 ● 变形场起源 ● 初始化与致密化 ● 场景编辑 ● 动态变形 ● 目标论文

第 3 章 ← 重建线

改「从什么起点开始补点」。对照 GaussianPro、Revising Densification。

第 4 章 ← 编辑线

加「身份编码」把高斯分组,再删物体、补空洞。对照 Gaussian Grouping、SPIn-NeRF。

第 5 章 ← 变形线

规范空间 + 变形 MLP 做动态重建。对照 Deformable 3D Gaussians、D-NeRF。

01

地基:场景到底该被什么表示

后面所有论文都在改这个问题的答案。NeRF 说「用神经网络的权重」,3DGS 说「用几百万个椭球」。 这一换,换来的是训练从两天变四十分钟、渲染从十秒一帧变一秒一百三十帧。

01 NeRF · ECCV 202002 3D Gaussian Splatting · SIGGRAPH 2023
01

NeRF:把整个场景塞进一个小神经网络

Neural Radiance Fields · ECCV 2020
重建 · 地基
Mildenhall et al.

一句话

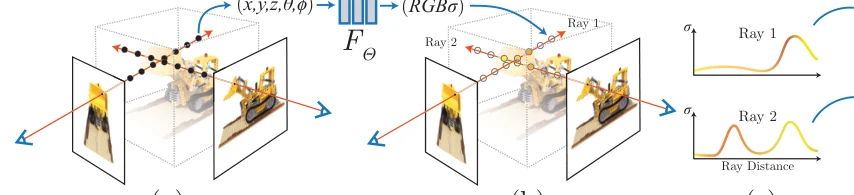
给网络一个空间坐标和一个观察方向,它告诉你那个点「有多实」(密度 σ)和「朝这个方向看是什么颜色」; 再沿相机视线把所有点积起来,就得到这张图的一个像素。因为整条链路可求导,只用一堆已知位姿的照片做梯度下降,就能把网络「训练成」这个场景。

它之前卡在哪

  • 用体素/网格存场景 → 分辨率受限;LLFF 单个场景要 >15 GB
  • 用模板网格做可微渲染 → 真实无约束场景根本拿不到模板
  • 隐式场要沿光线反复查询网络 → 又慢又难做高频细节
NeRF 方法总图
图 2 |NeRF 的完整闭环:(a) 沿光线采样 5D 坐标 → (b) MLP 输出 (RGB, σ) → (c) 体渲染合成图像 → (d) 与真值算损失并反传。「正向渲染」和「反向优化」都在这张图里。

两个关键设计

  • 位置编码:把坐标升到高维高频基底,MLP 才拟合得出细节(不加就糊,PSNR 掉 2.2 dB)
  • 分层采样:先粗采 64 点估个大概,再在「可能有东西」的区间细采 128 点,采样更省也更准

为什么它重要

它贡献了两个被后面所有工作继承的东西:
① 「辐射场」这个概念——场景 = 位置/方向 → 颜色/密度的函数;
② 体渲染公式——3DGS 的 alpha 合成正是它离散化后的样子。

代价:单场景训练 100k–300k 次迭代、V100 上 1–2 天;渲染时每条光线要查询网络 192 次。 而且模型是一堆网络权重,里面没有任何可以直接抓住、单独删掉或移动的几何实体—— 这正是后面「为什么需要 3DGS」以及「为什么编辑很难」这两件事的源头。
02

3DGS:不用神经网络,用几百万个椭球「摆」出场景

3D Gaussian Splatting · SIGGRAPH 2023
重建 · 地基
Kerbl et al.
3DGS 方法总图
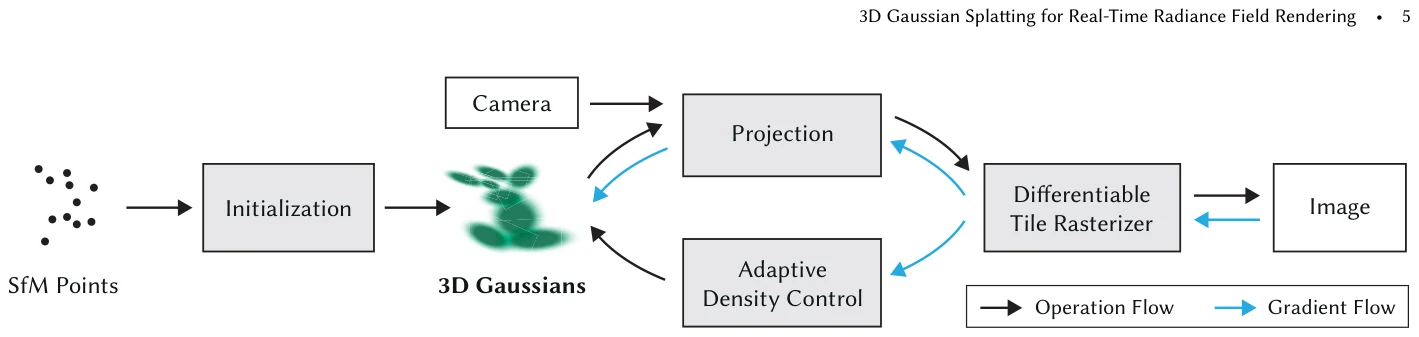
图 2 |从 SfM 稀疏点云初始化高斯,一边投影光栅化、一边自适应控制密度。黑箭头是数据流,蓝箭头是梯度流。

关键洞察:两个公式其实是同一个

NeRF 体渲染的 alpha 合成,和点泼溅的 alpha 混合,本质是同一条公式。既然公式一样,就没必要用「连续场 + 沿光线采样」这种昂贵实现,可以直接用 GPU 光栅化天生擅长的显式图元。

每个高斯学什么

位置 μ、不透明度 α、球谐系数(颜色)、以及协方差 Σ = R S Sᵀ Rᵀ。 协方差拆成旋转 + 三个轴长分别优化,这样无论怎么更新都保证是合法椭球。
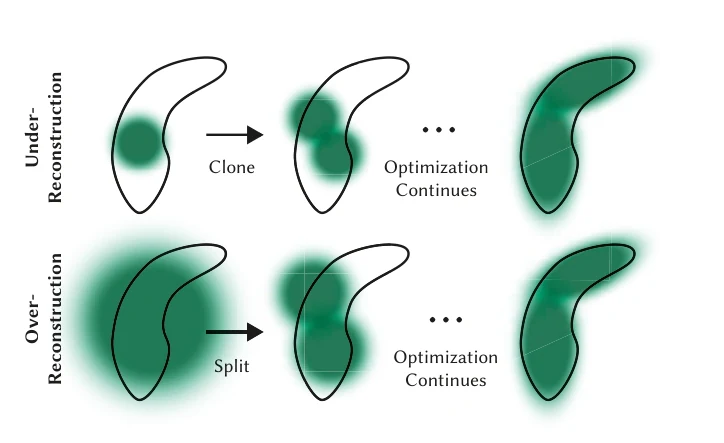
自适应密度控制
图 4 |致密化:小高斯盖不住 → 克隆;大高斯盖太多 → 分裂。

自适应密度控制(ADC)—— 后两篇论文都要打这里

  • 判据:高斯在屏幕空间的位置梯度平均值 > 0.0002,就认为该处没建好
  • 克隆:欠重建区域的小高斯,复制一份并沿梯度方向挪一点
  • 分裂:过重建区域的大高斯,拆成两个,缩放除以 1.6
  • 剪枝:不透明度 < 0.005 的、世界空间过大的、屏幕足迹过大的

换来的结果

Mip-NeRF360 数据集上:
训练 41 分钟(对比 48 小时)
渲染 134 fps(对比 0.06 fps)
画质 SSIM / LPIPS 反超

03

把 NeRF 和 3DGS 摆在一起看

这张表是后面所有讨论的基准
对照
NeRF(2020)3DGS(2023)这差别意味着什么
三维表示一个 MLP 的权重数百万个显式高斯椭球高斯可以被单独抓住、增删、移动
渲染方式沿每条光线采样、查询网络 192 次投影成 2D 椭圆,排序后 alpha 混合渲染快约 2000 倍
场景信息藏在哪网络的隐式权重里每个高斯的属性里NeRF 没法「挑出某一块来改」
初始化不需要(从头训)强依赖 SfM 稀疏点云点云烂 → 重建就差(随机初始化掉 5.6 dB)→ 张论文第 3 章的入口
语义/实例信息无无不知道哪个高斯属于哪个物体 → 张论文第 4 章的入口
时间维度假设场景静止假设场景静止动起来就糊 → 张论文第 5 章的入口
训练 / 渲染1–2 天 / 0.06 fps41 分钟 / 134 fps显存代价:3DGS 峰值可超 20 GB
这张表最后三行,就是张波涛论文三章的选题来源。它们不是凭空想出来的三个点,而是 3DGS 这个表示本身留下的三个缺口: 起点不可控(初始化)、不可编辑(无语义)、不可动(无时间)。后面每一篇前作,都是在填其中一个洞。
02

张论文第 3 章的入口:点云不够好

3DGS 的起点是 SfM 给的稀疏点云。可 SfM 在白墙、路面、天空这类没纹理的地方基本找不到点, 3DGS 只能在别处「就地」克隆分裂,长出一堆位置和朝向都不对的高斯。 两篇论文从两个不同角度攻这个问题:一个管「往哪补」,一个管「何时补」。

03 GaussianPro · ICML 2024 → 往哪补04 Revising Densification · ECCV 2024 → 何时补
03

GaussianPro:让点云自己沿着表面「长」出来

ICML 2024 · 中科大等
重建 · 初始化
Kai Cheng et al.

痛点

SfM 在无纹理区产不出点,这些区域完全没被初始化。3DGS 的克隆/分裂只能从已有高斯就地产点,起点就错了, 结果整条街道的地面被几个巨大的错误高斯「糊」过去,换个视角就崩。

关键洞察

3D 高斯的「谁挨着谁」在三维里很难算;但投影到 2D 后,同一个局部平面上的高斯,投影必然落在相邻像素、且深度和法向接近。 那就借用多视图立体视觉(MVS)的成熟武器——局部平面补丁匹配 + 多视图光度一致性——在 2D 上传播几何,再反投影回 3D。
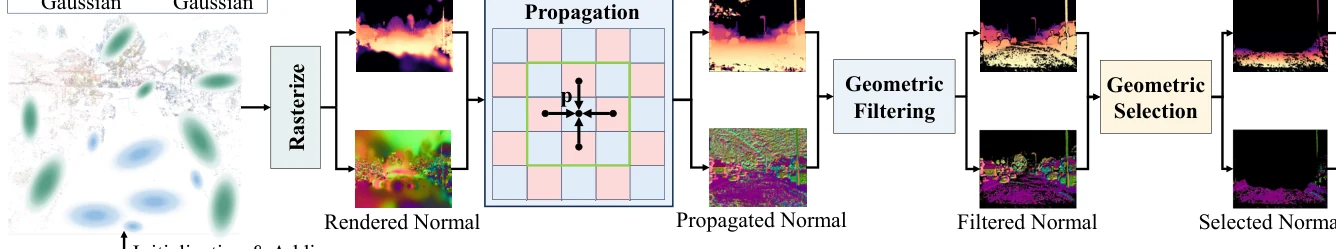
GaussianPro 方法总图
图 2 |训练中每隔 50 次迭代跑一遍传播:光栅化出深度/法向图 → 补丁匹配传播 → 几何过滤 → 与渲染深度差得多的像素反投影成新高斯。

补点的四步

  • 把当前高斯渲染成深度图 + 法向图(法向取椭球最短轴方向)
  • 每个像素按棋盘格挑 8 个邻居,把邻居的平面「传」过来,用单应变换 warp 到相邻视角比颜色
  • 多视图几何一致性过滤:不可靠的传播结果直接丢掉
  • 过滤后深度与渲染深度相对差 > 0.8 的像素 → 就是没建好的地方 → 反投影成新高斯

不只补点,还管形状

传播出来的法向图当伪标签,加一个平面约束损失去监督高斯的朝向——让老点也长得更像真实表面。

效果:Waymo 街景 PSNR 33.53 → 34.68(+1.15 dB),FPS 不降反升;几何精度提升是数量级的(深度 AbsRel 0.349 → 0.081)。 而且高斯数比「硬堆点」的版本少 30%,质量反而更高——说明增益来自位置和朝向准,不是点多。
但代价要看清楚:相对原版 3DGS 多花约 +25%~40% 训练时间; 而「直接喂一份更好的 MVS 点云再跑 3DGS」要 约 4 倍时间,质量却几乎打平。
这句话是张论文第 3 章最需要回应的对照。
04

Revising Densification:3DGS 判断「该不该加点」的尺子,本身是坏的

ECCV 2024 · Meta Reality Labs
重建 · 致密化
Rota Bulò et al.

它攻击的是上一页那个判据

3DGS 用位置梯度决定要不要加点。但梯度只对「误差变不变化」敏感,对「误差本身有多大」是瞎的。
一片草地被几个大高斯糊住时,误差很大,可高斯在小范围里怎么挪都不改变误差 → 梯度≈0 → 永远不补点,一直糊着。

关键洞察

把判据从一阶梯度换成零阶误差:直接算每个像素的重建误差,按各高斯在该像素的混合权重把误差「分摊」下去, 谁背的误差大,就让谁优先分裂。判据从「误差的变化率」变成「误差本身」,量纲直观,阈值也好设。
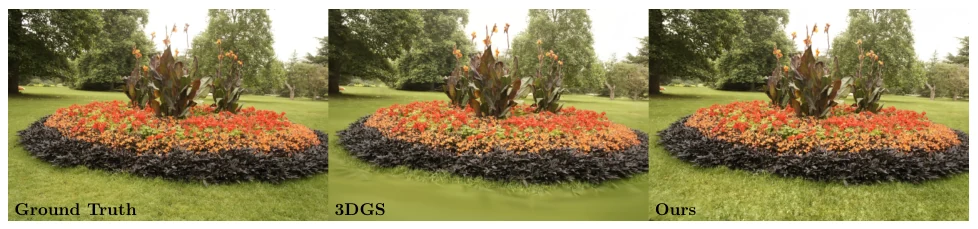
Revising Densification 效果
图 1 |下半部是草地:3DGS 把高纹理区糊成一片色块,本方法能还原出来。很反直觉——纹理越丰富的地方反而越容易糊。

误差得分怎么算(三步)

  • 对每个像素算一个误差(本文用 SSIM)
  • 按各高斯在该像素的 alpha 混合权重分摊给每个高斯
  • 两次致密化之间,取所有视角上的最大值当得分;> 0.1 才允许长大

顺带修了三个坑

  • 克隆后的不透明度修正:α̂ = 1 − √(1−α),不改的话克隆品权重被系统性放大
  • 增长上限:按得分排序保留,每次最多新建 5%(防止 OOM)
  • 平滑不透明度衰减替代原有的硬重置
代价几乎为零:高斯总数被显式限制在等于 baseline 的数量,所以模型大小、显存、渲染速度全都不变。 但它不改「点从哪来」,只改「什么时候加」——所以它和 GaussianPro 是可以叠加的,和「换一份更好的点云」这件事则完全正交。
3

张论文第 3 章做了什么

不换判据,也不从外部找几何依据,而是换一个更好的起点
目标论文 · 第 3 章
优化点云数据驱动的性能改进

五步流程

  • SfM 点云 → 跑第一次 3DGS
  • 从球谐系数里切出椭球中心颜色:sh[:, :3, 0],再 rgb = C₀·f_dc + C₁
  • 得到直接带颜色的密集点云(点云数量级 3.92 万 → 26.57 万)
  • 用半径滤波去噪
  • 降噪后的点云作为新输入,跑第二次 3DGS

它识别出的两类噪声

  • 接近透明的椭球(不透明度≈0.005)→ 产生「漂移点」,出现在重建目标前方或上方,稀疏散乱
  • 对非主要目标过度学习 → 产生「孤立点」,远离主目标,小而密集

论文逐一论证了直通/条件/体素/统计滤波都不适用,最终选半径滤波: 邻域半径取所有投影近似圆半径的最小值,邻域最少点数 K=3(与 3DGS 初始化时用的 K 一致)。
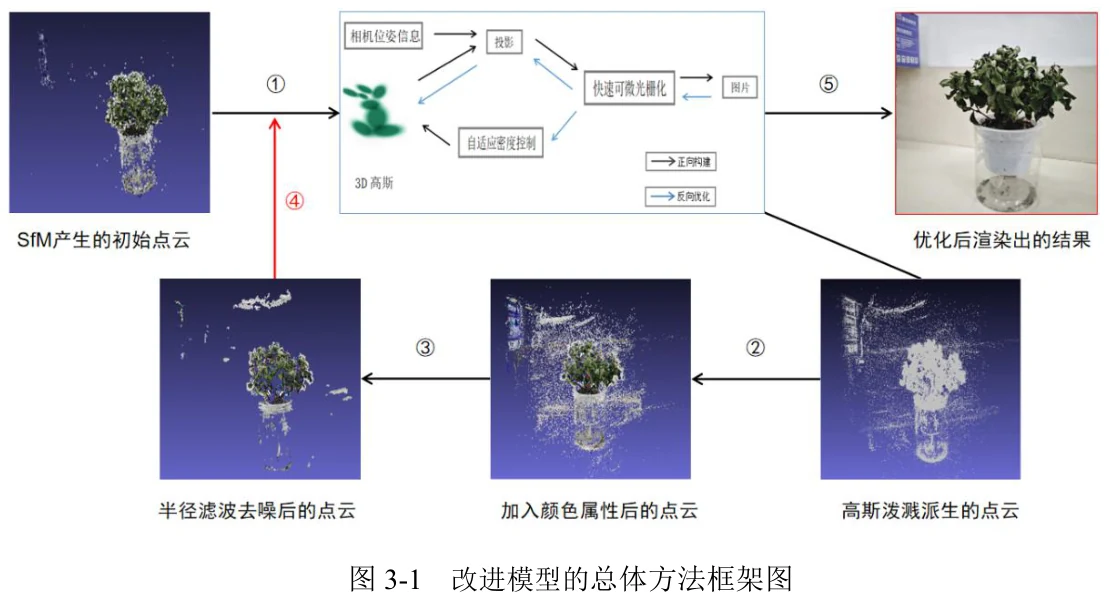
张论文图3-1 改进模型总体方法框架图
图 3-1 |张论文的方法框架图(论文第 24 页):① SfM 初始点云 → ② 3DGS → ③ 提取彩色点云 → ④ 半径滤波 → ⑤ 反馈回 3DGS 重建。

报告的实验结果

在 Mip-NeRF360 上:SSIM +0.034、PSNR +0.685、LPIPS −0.081;
Deep Blending:+0.002 / +0.072 / −0.019;
Tank&Temples:+0.014 / +0.382 / −0.012。
提升幅度在 Mip-NeRF360 上最明显,在另两个数据集上较小。

3

三条路线摆在一起:谁改了什么

这是本阶段最重要的一张表
对照 · 第 3 章
GaussianPro(03)Revising Densification(04)张论文第 3 章
改的是哪一环「往哪补」——新点的位置和朝向「何时补」——加点判据「从什么起点开始补」——初始点云质量
新高斯从哪来2D 深度/法向图传播 + 反投影不变(仍是 clone / split)第一次 3DGS 的派生点云本身
几何依据有:多视图光度一致性 + 局部平面无(不需要)无任何外部几何先验
去噪 / 控制多视图一致性 + 阈值 + 天空 mask不透明度修正、增长上限、平滑衰减半径滤波(纯几何,工程简单)
要重训吗不重训,点直接插进同一个优化不重训要,从零跑第二次
额外代价+25%~40% 训练时间几乎为零≈ +100% 训练时间

它多了什么

  • 颜色属性的完整继承:第二轮训练一开始颜色就是对的,不必从随机颜色重新学
  • 工程极简:半径滤波不需要邻视图选择、天空分割、多视图一致性检查那一整套

它少了什么(也是会被追问的地方)

  • 没有引入任何几何先验指导补点,第二轮仍靠 clone/split 就地产点
  • 致密化判据仍是原生的梯度阈值——正是第 04 篇攻击的那个
  • 没有回答「多跑一次到底值不值」,也没做代价与高斯数的对比
建议准备的最小消融矩阵(四行): ① 原始 3DGS(跑一次);② 原始点云 + 第二次重训(隔离「单纯多训一轮」的效应,最关键的一行); ③ 第一次点云 + 第二次但不加滤波(隔离半径滤波的贡献);④ 全流程。 没有 ② 和 ③,"提升来自更好的点云"这个说法就无法与"多训了一轮"区分开。
03

变形场的起源:一个「规范空间」的妙招

这是全篇最抽象、但收益最大的一段。核心问题:场景在动,NeRF 那条「同一个点从不同照片看颜色应该一样」的假设就崩了。 解法是把当前时刻的点先搬回一个统一的标准姿势,再在那个姿势下查颜色和密度。
这个「统一姿势」叫规范空间,负责搬动的那个网络叫变形场。后面 3DGS 上所有动态工作,用的都是这一招。

05 D-NeRF · CVPR 2021 → 提出范式06 Nerfies · ICCV 2021 → 把它做扎实
05

D-NeRF:先把点「搬回标准姿势」,再查颜色

CVPR 2021 · 提出「规范空间 + 变形场」范式
变形 · 范式源头
Pumarola et al.
D-NeRF 方法总图
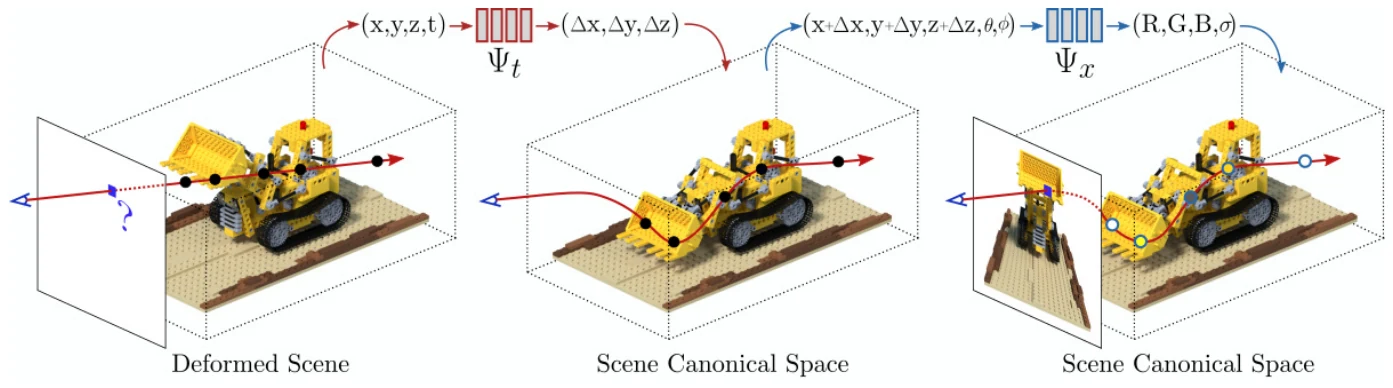
图 3 |左边是「当前时刻」的变形场景,中间的小网络 Ψt 算出每个点该往哪挪,右边是在规范空间里查颜色和密度。

一句话讲清这个范式

不给每个时刻单独学一个模型,而是学一张共享的静态场景(规范空间)加一个把当前时刻映射回去的位移场。 这样任意两帧之间就通过规范空间「串」起来了——某一帧某个视角看不到的地方,可以从别的帧补回来。

成立的前提(很重要)

物体可以移动、可以变形,但不会凭空出现或消失。 所有帧说的是同一批点,只是位置不同——这就是「搬回去」这个动作能成立的物理依据。

网络怎么分工

  • 变形网络 Ψt(x, t) → Δx:8 层 MLP,只管算位移,输出层不加非线性(因为位移要能正能负)
  • 规范网络 Ψx(x, d) → (c, σ):输出颜色和密度,只有它管「长什么样」
  • 硬约束:令 t=0 时位移为 0,也就是规范空间就是第 0 帧
  • 课程学习:按时间从小到大逐步加入图片,防止一上来就面对大变形

一个关键的「没有」

D-NeRF 完全没有变形正则化项。它防「变形乱动」只靠三件事:规范时刻硬约束、端到端联合训练、课程学习。

所以它在大变形、视角稀疏时会退化。补上这个洞的是下一篇 Nerfies。

它给后面留下了什么:「规范空间 + 以时间 t 为条件的变形场」这一整套骨架,以及一个公开数据集(8 个动态合成场景)。 张论文第 5 章用的时间标签、按时间排序的图像集、预热迭代,都是这条思路的延续;实验用的也正是 D-NeRF 的数据集和基线。
06

Nerfies:变形场不能乱动,得管住它

ICCV 2021 · 补上正则化、参数化和优化稳健性
变形 · 正则化
Park et al.

它指出的根本问题

「联合优化 NeRF + 变形场」是一个欠约束问题。物体往后移动和物体缩小,在图像上看起来一样,中间还有无数个解。 不加先验,网络会给出扭曲、不合理的变形——看起来渲染对了,几何全是错的。

第三个改进:条件变量换了

D-NeRF 用时间 t 当条件;Nerfies 改成每帧一个可学习的隐变量 ωᵢ。 好处是不要求帧有时序、也不要求时间均匀,适合手机随手拍。代价是失去了显式的时间含义。
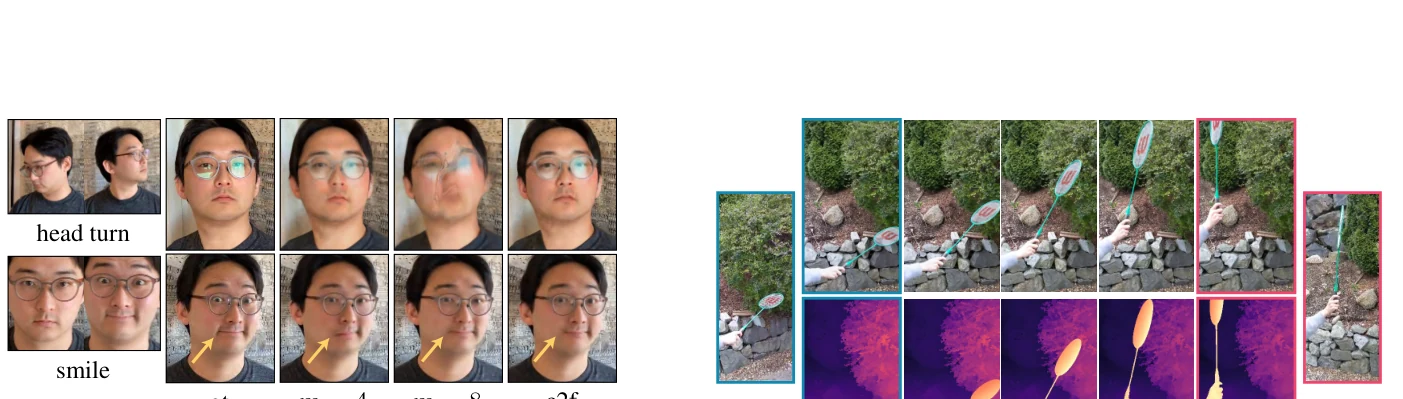
Nerfies 由粗到细训练
图 5 |转头 + 微笑的例子。m=4(只学低频)学不会微笑,m=8(一上来就放开高频)转头失败, 只有由粗到细两者兼得。

四道「别乱动」的防线

  • 弹性正则:算变形映射的雅可比矩阵,惩罚它的奇异值偏离 1——也就是惩罚局部被拉伸/压扁/撕开,要求「尽可能刚」
  • 鲁棒化:人不是完全刚性的(会有表情),所以对弹性项套一层鲁棒误差函数,降低异常点权重
  • 按贡献加权:空白区域本来就该自由变形,不强行要求刚性
  • 背景正则:SfM 里那些应当静止的三维点不许乱飘

还有一招:由粗到细

用滑动窗控制位置编码的频带——训练早期只允许学平滑的大动作,之后逐步放开高频细节。 这样能避开变形场的局部极小值。

为什么这一段对读懂张论文特别重要:Nerfies 花了一整节论证「正则化不可省」。 而张论文第 5 章的正文里没有任何显式的变形正则化或时序平滑机制—— 这是汇报时最容易被打到的地方,需要提前想好怎么解释(见后面第 31 页)。
07

小结:这个范式为什么必须换到 3DGS 上

范式没问题,是「挂载它的表示」太贵了
对照

范式本身:成立

D-NeRF 用三行分别展示规范空间、t=0.5、t=1.0 三个状态。 同一个物理点在三个状态下颜色一致,说明位移场确实学对了——而不是靠颜色硬编码糊过去。
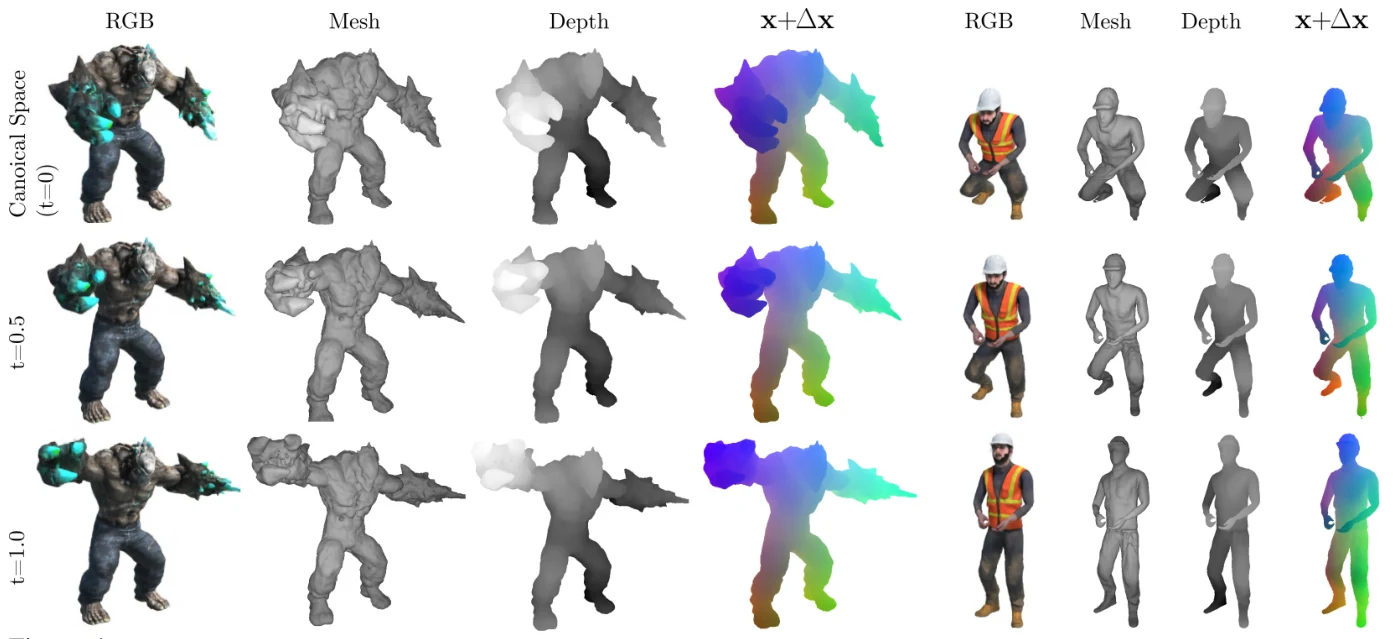
D-NeRF 规范空间可视化
D-NeRF 图 4 |每组四列分别是 RGB、网格、深度、位移着色;三行是规范空间与两个时刻。

但代价高得离谱

D-NeRF / Nerfies换成 3DGS 后
训练D-NeRF 单卡 2 天
Nerfies 全高清 8 卡 1 周
张论文第 5 章:
0.16 – 0.96 小时
渲染沿光线采样 64 点跑 MLP投影 + alpha 混合,实时
高频细节Nerfies 要专门拿一张图
展示「能重建发丝」
3DGS 天然擅长
所以「D-NeRF 的范式 + 3DGS 的表示」是水到渠成的下一步。 张论文第 5 章把隐式场换成规范空间的显式高斯集合,正是这个组合。下一阶段要看的,就是 3DGS 上怎么做变形、以及别人已经做到什么程度。
04

张论文第 4 章的入口:场景能建,但动不了

3DGS 建出来的是一堆离散、散乱、没有语义的高斯。想在场景里「把那只熊删掉」, 你没法告诉程序「哪些高斯是熊」——几百万个高斯,没有任何一个带标签。
这一阶段的全部工作,就是把「身份」这件事塞进每个高斯里。

07 SPIn-NeRF · CVPR 2023 → NeRF 上的删物体08 Gaussian Grouping · ECCV 2024 → 身份编码与分组
07

SPIn-NeRF:在 NeRF 上「点几下,把物体删掉补好」

CVPR 2023 · 注意:这是 NeRF 路线,不是 3DGS
编辑 · 基线
Mirzaei et al.
SPIn-NeRF 输入输出
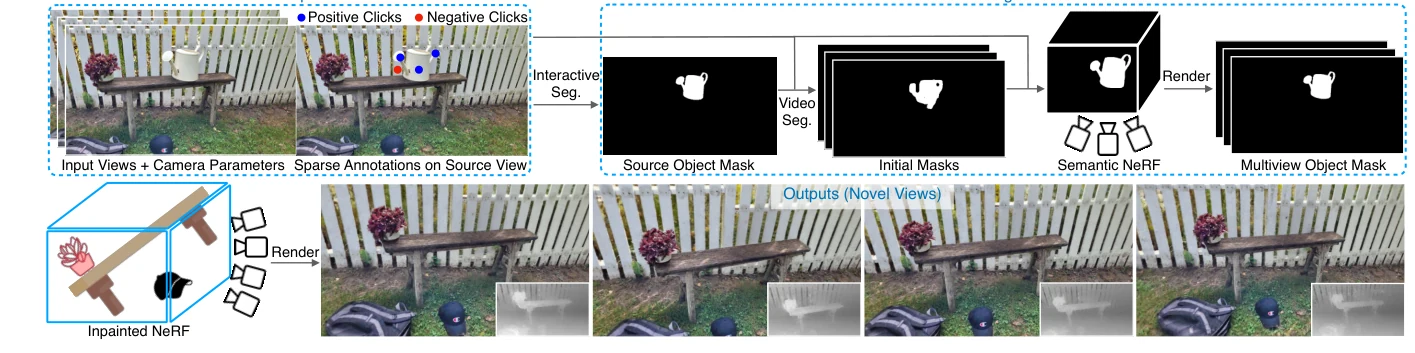
图 1 |左上:单张源视图上点几个正/负点;右上:自动传播到所有视角的掩码;下方:修补后的新视角渲染(附渲染深度小图)。

它之前卡在哪

  • NeRF 表示是纠缠的:场景信息全隐式编码在 MLP 权重里,不像图像或网格那样能直接挑出一块来改
  • 2D 分割模型不懂 3D:单图掩码投到别的视角就残缺(被遮挡的部分根本投不到)
  • 3D 修补的两难:既要单视角看着真实,又要跨视角一致——而逐视角修补出来的结果本身就是互相矛盾的

关键洞察

不训 3D 修补器(数据量根本不够),而是把现成的、不懂 3D 的 2D 模型(交互式分割 + 视频分割 + LaMa 图像修补)的输出「蒸馏」进 3D。 并且用感知损失 LPIPS 而不是像素 MSE 来监督掩码区域——因为 LPIPS 允许细节上不完全一致,从而容纳多视角 2D 修补结果之间的矛盾。

两个防退化的设计

  • 深度先验:把含物体的初始 NeRF 渲染的深度也修补一遍,用它监督新 NeRF——专门治「为了解释矛盾而在相机附近长出雾状几何」
  • Patch 级优化:算 LPIPS 要渲染整图,显存吃不消,于是只渲染掩码包围盒内的小块
结果:分割 mIoU 达到 91.66(视频分割基线 88.34);修补 LPIPS 0.4654,优于 NeRF-In 的 0.5699。同时贡献了一个带「无物体真值视角」的数据集,让 3D 修补第一次有了可评测的基准。
它在张论文里的角色:张论文第 4 章把 SPIn-NeRF 当作对比基线,而不是方法来源(论文 §4.3.2 明确写「选取 SPIn-NeRF 模型作为对比」)。 它的价值在于:它是「为什么必须从 NeRF 转向 3DGS」的动机来源之一——隐式、不可分解、要交互、慢。
08

Gaussian Grouping:给每个高斯挂一串「身份码」

ECCV 2024 · ETH Zurich | 张论文第 4 章的方法骨架来源
编辑 · 分组
Ye, Danelljan, Yu, Ke
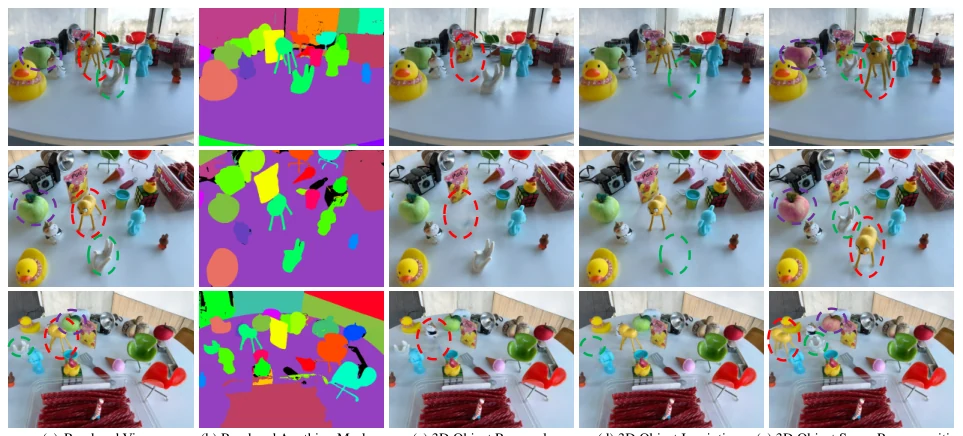
Gaussian Grouping 总图
图 1 |(a) 渲染视角 (b) 渲染出的 anything 掩码 (c) 3D 物体移除 (d) 修补 (e) 场景重组 + 换色。

关键洞察

3DGS 的每个高斯是离散、显式、可单独操作的。那就把「身份」也做成每个高斯的一个可学习属性, 和颜色完全平级处理,再用 SAM 的 2D 掩码去监督。训完之后,同一个物体上的高斯的身份码会自然聚在一起—— 于是「删掉某物体」就变成「把这一组高斯删掉」,不用重新训练。

四步流程

  • SAM 的 everything 模式逐图生成掩码(此时同一物体在各视角 ID 不同)
  • 把多视角图像当成一段视频序列,用零样本跟踪器 DEVA 关联同一实例
  • 每个高斯加 16 维 Identity Encoding,改可微光栅化器把它泼溅到 2D
  • 损失 = 2D 交叉熵(间接监督)+ 3D 近邻正则(直接约束编码)

为什么必须有 3D 正则项

只用 2D 损失会出现「透明熊问题」:熊内部那些在所有训练视角都被遮挡的高斯得不到监督,编码学不出来。 3D 正则要求空间上相邻的高斯编码接近,把这块补上。消融显示近邻数 K=5 时移除准确率从 41.2% 提到 76.6%。

跨视图关联为什么不用「线性分配」

基于代价的线性分配每次渲染迭代都要重算匹配:2K 次迭代要 1 小时、掩码噪声大、重建细节丢失; 换成 DEVA 零样本关联只要 1 分钟,提速 60 倍以上。而且当 DEVA 的 2D 掩码本身有错时,3D 高斯表示还能反向纠错。

结果与代价

LERF-Mask 上 mIoU 69.7 / 77.0 / 71.7(LERF 只有 33.5 / 28.3 / 49.7);全景分割速度约 140–150 FPS。
代价:加入身份编码后重建质量略微下降——PSNR 28.69 → 28.43,SSIM 0.870 → 0.863,FPS 约 200 → 170。

4

张论文第 4 章 vs Gaussian Grouping:逐项对照

这是全篇重合度最高的一章,需要逐项核对而不是笼统比较
对照 · 第 4 章
只陈述差异,不作定性判断
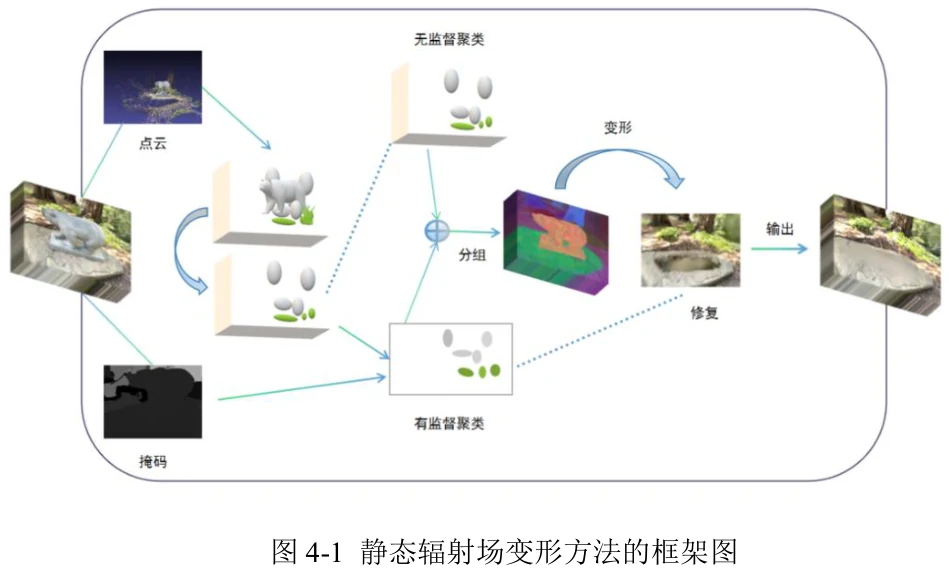
张论文图4-1 静态辐射场变形方法框架图
图 4-1 |张论文第 4 章框架:SfM 点云 + SAM 掩码(经 DEVA 跨视图关联)→ 带身份标识编码的分组高斯模型 → 选择类别 → 变形操作。
Gaussian Grouping(08)张论文第 4 章
身份属性每高斯 16 维 Identity Encoding,可学习每高斯 16 维身份标识编码,可微参数
2D 掩码来源SAM(everything)+ DEVA 关联SAM + DEVA 关联
特征视角相关身份与视角无关 → SH degree = 0未明确交代 SH degree
渲染方式改可微光栅化器,按深度 alpha 混合改可微光栅化器,按深度 alpha 混合
2D 监督16 维特征 → 线性层 → softmax → 交叉熵16×H×W → Conv2d → 256×H×W → 交叉熵
线性层16 → 256 通道16 → 256 通道
类别数 K文中说是场景掩码总数,实现固定 256按灰度图 0–255 论证为 256 类
3D 正则KL 散度,近邻 k=5,采样 m=1000KL 形式,近邻 k=3(对齐 3DGS 的 distCUDA)
空洞定位几何判据:渲染后无高斯覆盖的像素语义判据:Grounding-DINO 检测模糊区域 + DEVA 关联
空洞填补LaMa 监督新增高斯微调复制新高斯微调,掩码外 L1 + bbox 内 LPIPS,LaMa 监督

它多了什么

  • 用 Grounding-DINO 检测删除后的模糊区域(Gaussian Grouping 用的是几何判据),并显式写出 L1 + LPIPS 的修补损失组合
  • 把训练时间作为定量对比指标单列成表,与 SPIn-NeRF 正面比较
  • 前置的第 3 章(点云提色与去噪)与本章无继承关系,属独立贡献

它少了什么

  • 没有分割质量本身的定量评测(如 mIoU)——只报了 PSNR/SSIM/LPIPS 和训练时间,证明不了分组/分割有多准
  • 没有对新增模块的消融:身份编码、3D 正则、Grounding-DINO 各自贡献多少,没有单独验证
两处需要自己先核对的数值(不影响结论,但汇报时可能被问到): ① 论文正文 §4.3.3 写 Grizzly Bear 的「SSIM 提高了 0.032」,但按表 4-1 的数据算是 0.9063 − 0.9031 = 0.0032,差一个数量级; ② 表 4-1 与表 4-2 中 Kitchen 的 OURS 不一致(SSIM 0.8730 vs 0.8713,LPIPS 0.1790 vs 0.1776)。 建议上幻灯片前先核对。
05

张论文第 5 章的入口:场景会动,表示不会

把第 03 阶段的「规范空间 + 变形场」那一招,搬到 3DGS 上。这一阶段能看到三条完全不同的技术路线, 张论文明确选了第一条——理解另外两条,才能说清这个选择意味着什么、放弃了什么。

09 Deformable 3D Gaussians → MLP 变形场10 4D-GS → 时空平面11 SC-GS → 稀疏控制点12 GaussianMesh → 网格驱动
09

Deformable 3D Gaussians:把高斯「冻结」在标准姿势,再让它动
CVPR 2024 · 浙大 + 字节 | 张论文第 5 章最直接的对照
变形 · 动态
Yang et al.
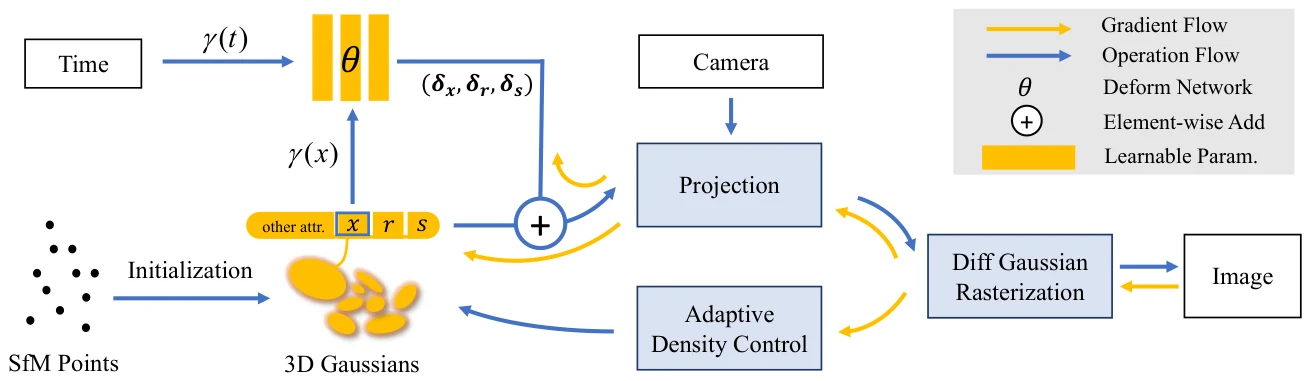
Deformable 3D Gaussians 方法总图
图 2 |SfM 点 → 3D 高斯 → 位置编码 γ(sg(x)) 与时间编码 γ(t) 送入变形网络 → 输出 (δx, δr, δs) → 加到规范高斯上 → 可微光栅化。标注了「前 3k 迭代 warm-up 不优化变形场」。

为什么不是「给每个高斯加时间参数」

那样做会让参数数量爆炸,而且违背可微光栅化器快速可微的初衷,还会丢失运动的时空连续性。 所以把运动与静态结构解耦:高斯学在规范空间里,用一个纯隐式 MLP 变形场把它映射到时刻 t。

变形网络做什么

(δx, δr, δs) = F_θ( γ(sg(x)), γ(t) )
只预测位置、旋转、缩放的偏移量;不透明度 σ 和球谐颜色不参与变形(外观只依赖规范空间和视角方向)。

它的正则化:退火平滑训练(AST)

训练早期往时间编码里注入随迭代线性衰减的高斯噪声,逼网络学平滑的时间泛化;后期噪声归零保住高频细节。 好处是不增加任何计算开销——比 D-NeRF 那种「额外加光滑损失」的做法更省。

结果

D-NeRF 合成数据集上 PSNR 全部第一(如 Hell Warrior 41.54 vs D-NeRF 24.06); 真实数据 NeRF-DS 上 24.11。消融显示去掉 AST 后 PSNR 只掉 0.14,但 SSIM 掉 0.018、LPIPS 差 0.027—— 它改善的是结构与感知质量,不是像素级 PSNR。

局限

强依赖视角多样性(视角稀疏会过拟合)与位姿精度;训练时间与高斯数量成正比; 只针对中等幅度运动。σ 和 SH 不参与变形,无法表达随时间变化的外观(如高光变化)。

10/11

另外两条路:4D-GS 与 SC-GS

张论文没走这两条,但要能说清为什么
变形 · 范式对比

10 · 4D-GS 把「某位置某时刻怎么动」存进 6 个平面

用多分辨率时空平面(xy / xz / yz / xt / yt / zt)编码每个高斯的时空特征,再用一个极小的三头 MLP 分别解码出位置、旋转、缩放的增量。运动知识存在离散的平面特征里,而不是 MLP 权重里。
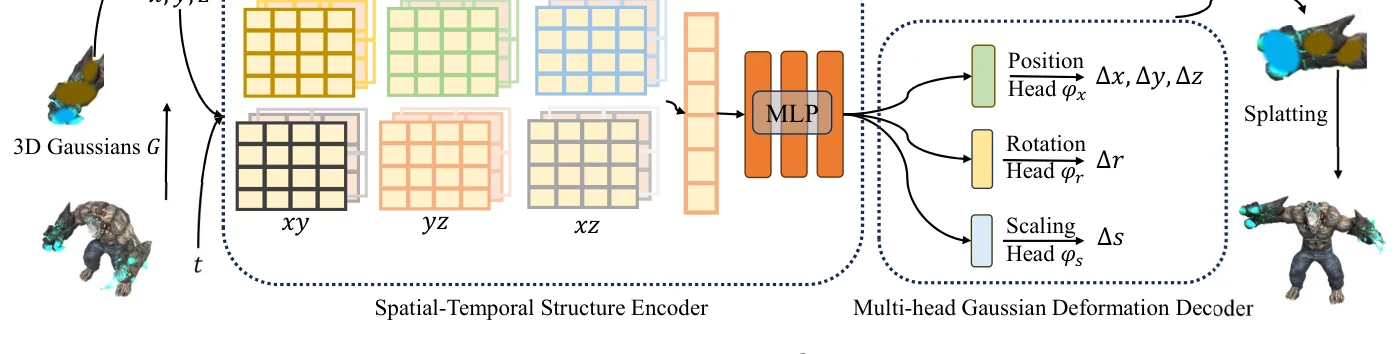
4D-GS 方法总图
4D-GS 图 3 |3D 高斯 → 6 平面时空编码器 → 小 MLP → 多头形变解码器 → splatting。
好处:训练 8 分钟、存储 18 MB、渲染 82 FPS——三者都最优。 代价:依赖低秩假设与有界体素网格,对无界/大场景不友好。

11 · SC-GS 用几百个控制点当骨架

放约 512 个稀疏控制点(对比 10 万级的高斯),每个控制点学一套随时间变化的 6 自由度变换,附近高斯按距离加权「跟随」。再加 ARAP 局部刚性约束,防止控制点乱动导致局部塌陷或穿模。
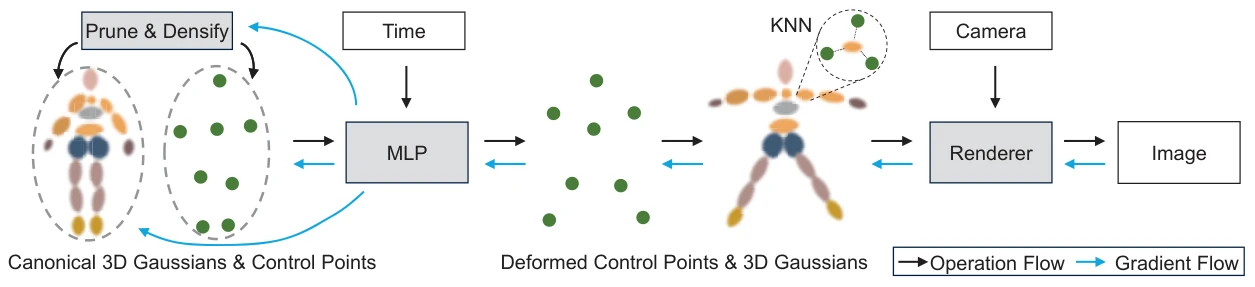
SC-GS 方法总图
SC-GS 图 2 |规范高斯 + 控制点 → Time → MLP → KNN → 形变后的控制点与高斯 → 渲染。
真独有的能力:用户可拖动控制点做运动编辑,能泛化到训练序列之外的动作用。 代价:假设运动局部刚性(对布料、流体不友好);真实数据上增益收窄(24.1 vs 23.7)。
09 Deformable 3D Gaussians10 4D-GS11 SC-GS
运动存在哪MLP 权重里(隐式、全局平滑)6 个时空平面特征(显式、离散、低秩)约 512 个控制点的 6DoF 变换(稀疏、紧凑)
变形网络单 MLP,8 层 × 256,单头输出 (δx, δr, δs)时空编码器 + 小 MLP + 三头解码器MLP 预测控制点变换 + RBF 加权 + LBS
正则化AST 退火平滑(加噪)L_tv(平面全变差)L_arap(局部刚性)
真独有能力时序平滑,无需额外开销最快 + 最省存储用户可控运动编辑
主要软肋依赖位姿与视角覆盖低秩假设、有界体素局部刚性假设、真实数据增益小
为什么张论文只能选 09 那条路:他的问题设定是「重建动态变形场景」,不是「让用户编辑运动」(他把用户可控编辑写进了第 6 章的未来工作)。 所以 SC-GS 那套「可编辑」的核心卖点对他不适用;4D-GS 的时空平面则需要额外的体素网格工程,与他「在规范空间学变形场」的表述也对不上。 这个选择本身是自洽的,但代价是——09 已经先发表了同一框架,增量必须靠消融来证明。
12

GaussianMesh:给物体套一层「网格皮」,拖着皮走

SIGGRAPH Asia 2024 · 标题最贴近「辐射场变形」的一篇
变形 · 大尺度
Gao, Yang, Zhang et al.
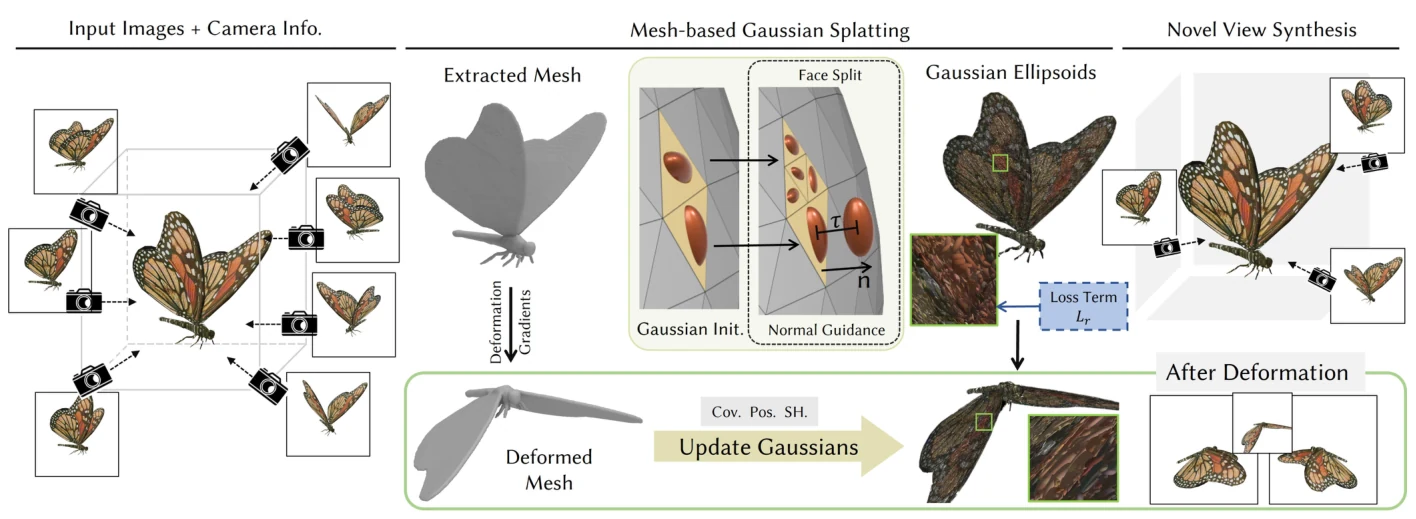
GaussianMesh 方法总图
图 2 |标定图像 → 重建显式网格并用它初始化高斯 → 训练中两条策略:(a) Face Split(面细分,高斯同步分裂)与 (b) Normal Guidance(高斯沿法向偏移)+ 正则 L_r → 变形阶段用用户控制网格的变形梯度直接驱动高斯参数。

关键洞察

3DGS 由离散、无连接关系的高斯构成,本身没有拓扑,所以大变形一定会散架。但如果给每个高斯绑定一个显式三角网格面, 让网格充当「变形载体」,高斯相对网格面做小偏移来保留高频细节——那么网格的变形梯度(旋转 R + 剪切 S)就能干净地传递到高斯的旋转与缩放上。 因为仿射变换下高斯分布形式不变,这一步是闭式的、无需任何再优化,所以能实时。

几个关键设计

  • 每个三角形面与高斯一一对应(不同于「一个面绑多个高斯」的做法)
  • 新增可学习量:重心坐标 w + 沿法向偏移比 τ(让高斯能离开表面一点,表达毛发/草状细节)
  • 正则 L_r:高斯最大尺度不超过所在面外接圆半径的 3 倍,抑制细长条高斯
  • 整条 pipeline 不含任何网络参数,只优化高斯与网格属性

结果

单张 RTX 4090 上平均 65 FPS(训练约 20 分钟);NeRF-Synthetic 上 PSNR 33.84 为全场最优。 消融显示 Normal Guidance 贡献最大(去掉后 33.84 → 32.17)。

局限

强依赖抽出的网格质量,抽不出网格就失效(如透明物体);只能改几何,外观和光照烘焙进高斯后不可改; 拓扑固定,做不了切开、打孔、断裂。

与张论文的关系:不同支路线。张第 4 章是语义层面的编辑(分割即目的),GaussianMesh 只是把分割当成变形前的预处理; 张第 5 章做的是重建观测到的运动,而不是用户主动编辑。它的价值在于说明「用户可控大尺度变形」这一支已经做到什么程度—— 这也正是张论文第 6 章列出的未来方向。
5

张论文第 5 章 vs Deformable 3D Gaussians

框架高度对应,差异集中在少数几个点
对照 · 第 5 章
只陈述差异,不作定性判断
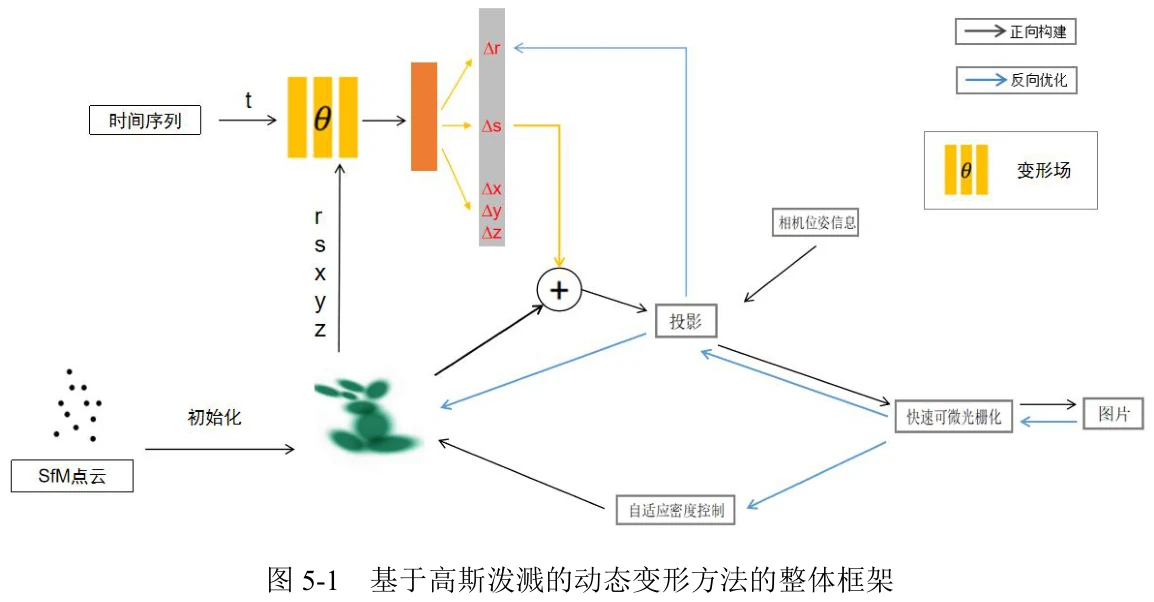
张论文图5-1 动态变形方法整体框架
图 5-1 |张论文第 5 章框架图(论文第 49 页)。
Deformable 3D Gaussians(09)张论文第 5 章
整体框架规范空间高斯 + 纯隐式 MLP 变形场,解耦运动与结构「在规范空间学习变形场」「与变形场解耦」
网络输入γ(sg(x)) 与 γ(t),位置停止梯度γ(x) 与 γ(t),时间「间接条件化」
时间编码阶数合成集 L(x)=10、L(t)=6;真实集都用 10位置与时间统一取 L=10
网络结构单 MLP,D=8,W=256,单头输出8 层 × 256,第 4 层加残差连接,最后 3 层无激活
输出量(δx, δr, δs);σ 与 SH 不变形(δx, δr, δs);σ 与 SH 不变形
预热前 3k 迭代只训高斯前 3k 迭代预热,不优化变形场
优化器单个 Adam,各分量不同学习率Adam;对 δx, δr, δs 各设独立优化器
正则化AST 退火平滑训练(核心贡献之一)正文未见任何正则化/平滑机制
损失函数渲染损失 L1 + D-SSIM,梯度回流变形场与高斯正文只提「可微光栅化反向优化」,未给出具体表达式
数据集D-NeRF 合成 8 场景 + NeRF-DS + HyperNeRFD-NeRF 数据集中的 4 个场景
基线3D-GS、D-NeRF、TiNeuVox、Tensor4D、K-Planes只有 D-NeRF(2021 年的隐式方法)
消融有 AST 专项消融(图 4 / 表 2)未见针对新增点的单独消融
一个可以提前准备好的说明:论文里「原始 3DGS」这一对照值,与 09 表中 3D-GS 行处在同一水平区间 (如张论文「独立小球」23.20、09 的 Bouncing Balls 23.20;张论文「恐龙骨架」21.96、09 的 T-Rex 21.93)。 这里只陈述数值事实,不作判断。被问到时应能说明这批数字是怎么测的、用的什么配置。
06

落到张波涛论文

前面十二篇是「前史」,现在可以把每一项创新还原到它的来源,并逐项问: 哪一部分是继承的、哪一部分是真正新增的、新增的部分有没有被单独验证。

论文总览三章继承 / 新增汇总最可能被追问的十个问题术语速查
13

目标论文:《基于高斯泼溅的辐射场变形方法研究》

华北理工大学硕士学位论文 · 导师韩兵 · 2025 年 6 月 · 全文 77 页
目标材料
核验等级 B

第 3 章 优化点云数据驱动的性能改进

问题:3DGS 重建会产生大量带信息的点云,但没被利用;而这些点云本身不带颜色。
做法:把派生点云提取出颜色 → 半径滤波去噪 → 反馈回去跑第二次 3DGS。
对应前作:GaussianPro、Revising Densification

第 4 章 基于高斯泼溅的静态辐射场变形

问题:几百万个离散高斯没有身份信息,没法把某个物体单独选中、删除。
做法:给每个高斯加「身份标识编码」→ 聚类分组成不同物体 → 移除 → 检测模糊区并复制新高斯修补。
对应前作:Gaussian Grouping、SPIn-NeRF

第 5 章 基于高斯泼溅的动态辐射场变形

问题:3DGS 假设场景静止,不能重建随时间变形的动态场景。
做法:带时间标签的图像 → 时间与位置编码 → 变形网络输出偏移量 → 与规范空间高斯联合优化。
对应前作:Deformable 3D Gaussians、D-NeRF
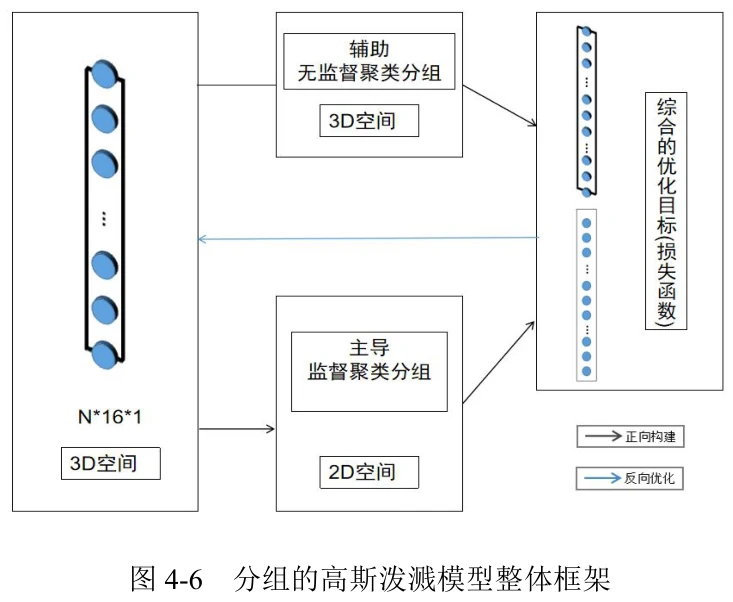
张论文图4-6 分组的高斯泼溅模型整体框架
图 4-6 |第 4 章的分组模型框架(论文第 41 页):二维掩码监督为主导,三维无监督为辅助,共享同一线性层。
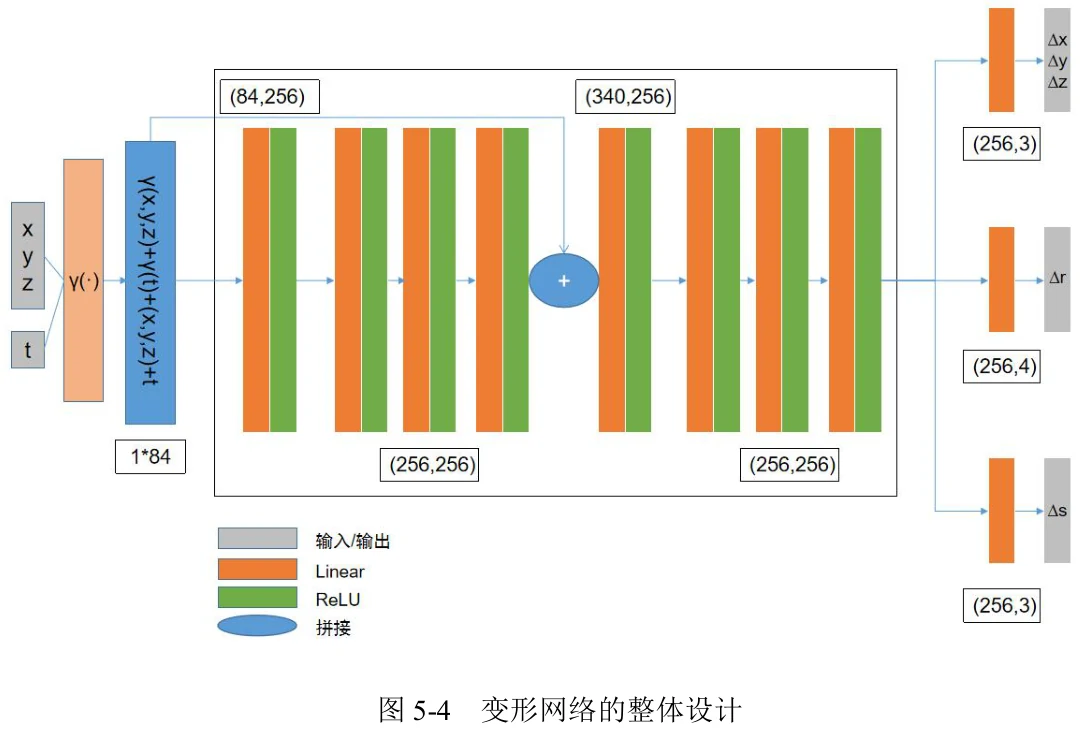
张论文图5-4 变形网络整体设计
图 5-4 |第 5 章的变形网络(论文第 53 页):输入 84 维 → 前 4 层 Linear+ReLU → 残差连接 → 最后 3 层输出 δx / δr / δs。
论文自己的问题意识(原文摘要):「原始的三维高斯泼溅模型存在一定的局限性,如:未能充分利用重建时产生的点云数据、重建的静态场景不能进行变形、无法重建动态变形场景。」 ——这三句正好对应上面三章。第 2 章是 3DGS 的理论基础,第 6 章是总结与展望。
审计

三章汇总:哪些是继承的、哪些是新增的

这张表是整场汇报的核心产出
创新审计
章节 直接继承的模块 相对前作的差异 / 新增 新增部分是否被单独验证
第 3 章
改初始化
3DGS 的球谐系数机制(用 sh[:,:3,0] 取直流分量即颜色)、3DGS 的致密化与优化流程、半径滤波算法本身 「提取颜色 → 转成点云 → 半径滤波 → 反馈重训」这条两阶段流程;把它包装成一个统一的性能改进模型 未做逐项消融:
没有「只多训一轮」的对照,也没有「不滤波」的对照
第 4 章
静态编辑
Gaussian Grouping 的:16 维身份编码、改可微光栅化器做 alpha 混合渲染、2D 交叉熵间接监督、3D 近邻正则、共享 16→256 线性层;SAM 与 DEVA 的用法;LaMa 做修补监督 用 Grounding-DINO 检测删除后的模糊区域并用 DEVA 关联检测框(前作用的是「渲染后无高斯覆盖」这一几何判据);明确写出掩码外 L1 + bbox 内 LPIPS 的修补损失;把训练时间作为定量对比指标单列 未做逐项消融:
只有「变形前 vs 变形后」与「vs SPIn-NeRF」,身份编码 / 3D 正则 / Grounding-DINO 各自贡献多少没有分离
第 5 章
动态变形
D-NeRF 的「规范空间 + 以时间为条件的变形场」范式、时间标签图像集与公开数据集;Deformable 3D Gaussians 的:规范空间高斯、变形 MLP 预测 (δx, δr, δs)、前 3k 迭代 warm-up、σ 与 SH 不参与变形 变形网络第 4 层加残差连接;对 δx / δr / δs 各设独立优化器;时间编码阶数统一取 L=10;前置第 4 章的静态变形作为基础 未做逐项消融:
残差连接、独立优化器、L 的取值都没有对照实验

三章共同的模式

三章都是「沿用已有框架 + 替换或增补一个环节」的结构,这本身是合理的工程路线。 问题在于:三章都没有把「自己新增的那一环」单独拎出来做消融,因此目前的实验只能证明「整体比基线好」, 无法证明「好在我新增的那一环上」。

这不是要下判断,而是要准备回答

学位论文与会议论文的评价标准不同,工程整合本身也可以是贡献。 但汇报时老师大概率会问上面这几处。提前想清楚「怎么补实验 / 怎么解释现有证据」, 比被问到时临场应对要从容得多。

追问

最可能被追问的十个问题

按「第几章 → 问题 → 建议的准备方向」组织
准备

第 3 章

  • 「多跑一次 3DGS 值不值?」
    准备方向:补「原始点云 + 第二次重训」这一行,把「多训一轮」的效应隔离掉。GaussianPro 的表 6 是最好的对照素材——它证明训练中补点只需 +25%~40% 时间就能逼近「换密点云再重训」的效果。
  • 「半径滤波到底有没有用?」
    准备方向:补「只换点云、不滤波」一行。另外注意半径滤波会损失细节,论文自己也承认了。
  • 「点云变好了,但致密化判据还是旧的?」
    准备方向:Revising Densification 正面攻击梯度阈值,且代价几乎为零、可以叠加。这是一个现成的改进方向。

第 4 章

  • 「你的分割本身准不准?」
    准备方向:目前只报了 PSNR/SSIM/LPIPS 和训练时间,缺 mIoU 这类分割指标。Gaussian Grouping 在 LERF-Mask 上是有基准的。
  • 「身份编码、3D 正则、Grounding-DINO 各贡献多少?」
    准备方向:前作对 3D 正则的近邻数 K 做了消融(K=0/1 时移除准确率只有 41%),说明这一项是真正起作用的,值得补。
  • 「与 Gaussian Grouping 的差别在哪?」
    准备方向:见第 17 页的逐项对照表,重点是空洞定位方式(语义检测 vs 几何判据)和修补损失。

第 5 章

  • 「变形网络和 Deformable 3D Gaussians 差在哪?」
    准备方向:残差连接、独立优化器、时间编码阶数——但目前没有消融证明这些改动带来多少增益。
  • 「为什么基线只有 D-NeRF?」
    准备方向:这是最明显的短板。同源的 3DGS 系方法(Deformable 3D Gaussians / 4D-GS / SC-GS,都是 CVPR 2024)一个都没比。
  • 「时序抖动怎么抑制?」
    准备方向:前作用 AST 退火平滑,Nerfies 用弹性正则。本论文正文没有对应机制,需要解释或补充。
  • 「初始输入为什么是 84 维?」
    准备方向:按公式(5-2)、L=10,位置编码 3×2×10=60、时间编码 2×10=20,合计 80;若再拼接原始的 3 个坐标和 1 个时间值,恰好 84。把这个口径说清楚即可。
最后一条(跨章节):数值一致性。 第 17 页已经列出两处需要核对的数字(正文 SSIM 提高 0.032 vs 表中实际 0.0032;表 4-1 与表 4-2 中 Kitchen 的数值不一致)。 另外,第 5 章表 5-2 里「原始 3DGS」的两个数值与 Deformable 3D Gaussians 表中 3D-GS 行的数值非常接近, 需要能说清测试配置和复现方式。这些不是结论性问题,但被追问时答不上来会很被动。
术语

术语速查表

汇报时被问到任何一个词,都能在这里找到一句话解释
附录

表示与渲染

  • 辐射场:把场景表示成「位置 + 方向 → 颜色 + 密度」的函数
  • 体渲染:沿视线把密度和颜色积起来得到像素值
  • 位置编码:把坐标映射到高维高频基底,让网络能拟合细节
  • 3D 高斯:位置 μ、不透明度 α、颜色 SH、协方差 Σ = R S Sᵀ Rᵀ
  • 球谐系数 SH:用一组基函数表示随视角变化的颜色;0 阶(第一个系数)就是与视角无关的基础颜色
  • alpha 合成:按深度排序后,把每个图元的颜色按权重累加
  • 可微光栅化器:能反传梯度的光栅化器,是 3DGS 能训练的关键

训练与致密化

  • 致密化 ADC:自适应密度控制,决定何时增删高斯
  • 克隆 / 分裂:小高斯盖不住就复制,大高斯盖太多就拆成两个
  • 不透明度重置:周期性把 α 压小,抑制相机附近的漂浮物
  • PSNR / SSIM / LPIPS:像素误差 / 结构相似度 / 感知距离(LPIPS 越低越好,更贴近人眼)
  • 感知损失:用 LPIPS 而非像素 MSE 做监督,允许细节不完全一致

变形与编辑

  • 规范空间:一个统一的标准姿势,所有时刻的点都搬回这里查询
  • 变形场:把当前时刻的点映射回规范空间的网络
  • 停止梯度 sg(·):算梯度时把某个量当常数,防止变形场反过来改动坐标
  • warm-up:先只训高斯、暂不训变形场的一段预热迭代
  • 身份编码:挂在高斯上的可学习向量,用来区分不同物体
  • SAM / DEVA:自动分割一切 / 跨帧关联同一实例
  • LaMa:图像修补模型,负责「想象」被删掉的地方长什么样
  • Grounding-DINO:开放词表的目标检测模型
  • ARAP:尽可能刚性——变形时要求局部不被拉伸压扁
  • 控制点 / 时空平面:两种不同的运动载体(稀疏骨架 / 显式特征网格)
文献

参考文献

全部 13 篇均在本地文献包中,来源与授权见各篇的「来源说明」
附录

方向主线(12 篇前作)

  • Mildenhall et al. NeRF: Representing Scenes as Neural Radiance Fields for View Synthesis. ECCV 2020.
  • Kerbl et al. 3D Gaussian Splatting for Real-Time Radiance Field Rendering. ACM TOG 42(4), SIGGRAPH 2023.
  • Cheng et al. GaussianPro: 3D Gaussian Splatting with Progressive Propagation. ICML 2024.
  • Rota Bulò et al. Revising Densification in Gaussian Splatting. ECCV 2024.
  • Pumarola et al. D-NeRF: Neural Radiance Fields for Dynamic Scenes. CVPR 2021.
  • Park et al. Nerfies: Deformable Neural Radiance Fields. ICCV 2021.


  • Mirzaei et al. SPIn-NeRF: Multiview Segmentation and Perceptual Inpainting with Neural Radiance Fields. CVPR 2023.
  • Ye et al. Gaussian Grouping: Segment and Edit Anything in 3D Scenes. ECCV 2024.
  • Yang et al. Deformable 3D Gaussians for High-Fidelity Monocular Dynamic Scene Reconstruction. CVPR 2024.
  • Wu et al. 4D Gaussian Splatting for Real-Time Dynamic Scene Rendering. CVPR 2024.
  • Huang et al. SC-GS: Sparse-Controlled Gaussian Splatting for Editable Dynamic Scenes. CVPR 2024.
  • Gao, Yang, Zhang et al. Real-time Large-scale Deformation of Gaussian Splatting. ACM TOG 43(6), SIGGRAPH Asia 2024. DOI 10.1145/3687756

目标材料

张波涛. 基于高斯泼溅的辐射场变形方法研究. 华北理工大学硕士学位论文, 2025.
核验等级 B:学位论文对自身实现和实验是一手材料,不等于顶会同行评审证据。

方法中引用的工具模型

SAM(分割一切)· DEVA(零样本视频跟踪)· LaMa(图像修补)· Grounding-DINO(开放词表检测)

引用提示

PDF 仅用于个人科研阅读。正式引用请回到出版页导出 BibTeX。 GaussianMesh 本地文件是 ORCA 存档的作者接受版,不是 ACM 最终排版版。

谢谢
欢迎提问与讨论

一句话总结这份报告:张论文的三章,分别对应 3DGS 这个表示留下的三个缺口——起点不可控、不可编辑、不可动。
每一章都沿用了一条成熟的技术路线,并替换或增补了一个环节。真正需要回答的问题是:
自己新增的那一环,能否被单独验证。

下一步建议补齐四行最小消融(第 3 章)
其次是补分割质量指标(第 4 章)
再有是补同源 3DGS 基线(第 5 章)

总览 点任意一页跳转 · 按 Esc 或 O 返回

1 / 1